OVHcloud · Infrastructure · ServiceNow
OVHcloud : infrastructure ServiceNow et accompagnement SRE
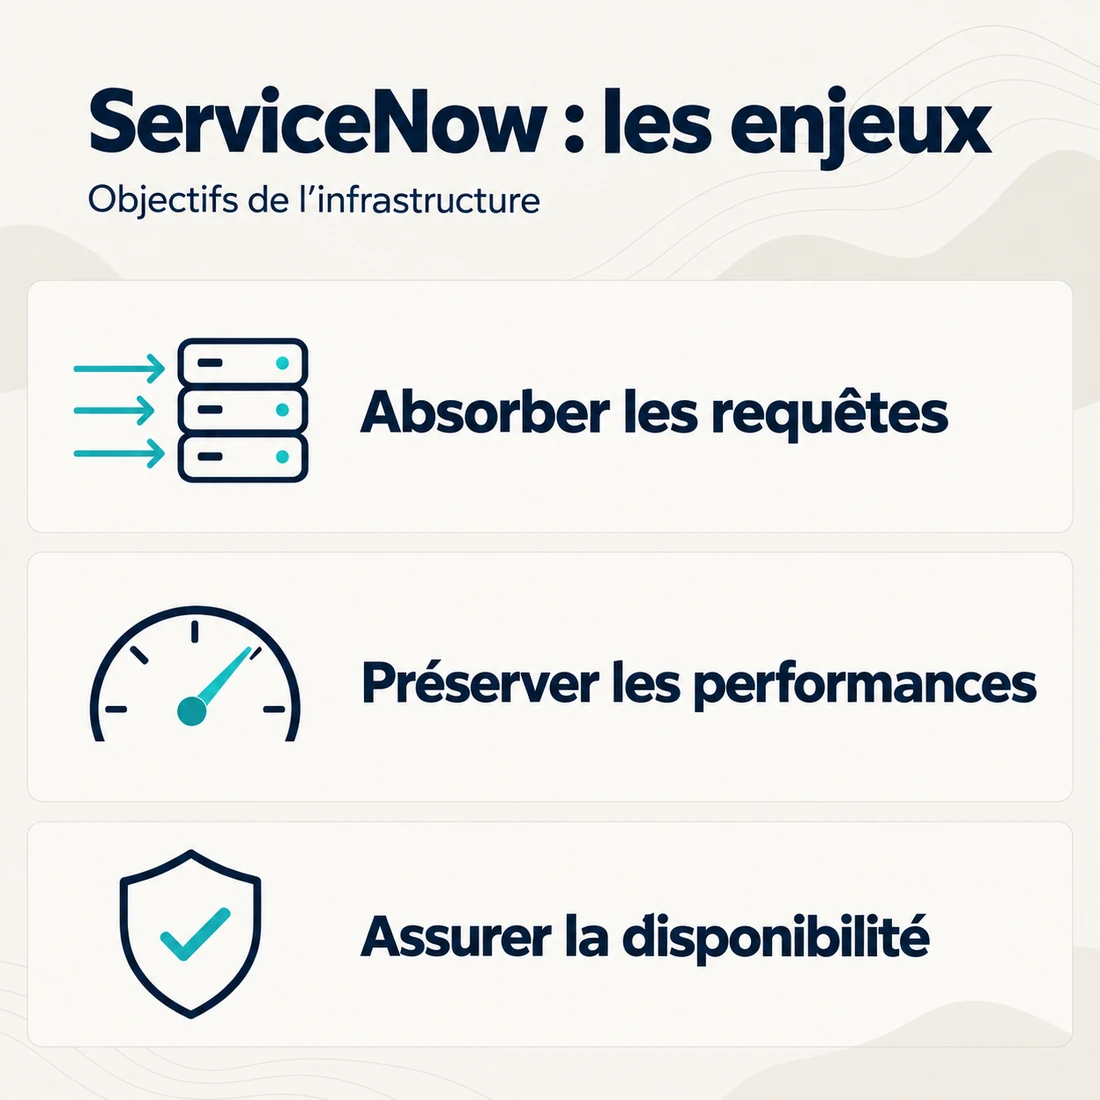
ServiceNow devait pouvoir absorber un volume important de requêtes quotidiennes tout en répondant aux exigences de performance et de disponibilité. J’ai travaillé sur ce socle d’infrastructure, avec une approche SRE qui relie conception, automatisation et exploitation.
Faire tenir ensemble charge, performance et disponibilité
Le point de départ était un besoin applicatif concret : fournir à ServiceNow une infrastructure capable de supporter un très grand nombre de requêtes par jour. Il fallait dimensionner le socle pour cette charge et préparer sa continuité d’exploitation.
Pour l’équipe cliente, l’enjeu est de pouvoir faire évoluer l’application sur une base technique adaptée à son usage. Une infrastructure difficile à reproduire ou à observer complique les changements autant que le traitement des incidents. La conception du socle et les conditions de son exploitation doivent être pensées ensemble.
Trois exigences qui orientent la conception
Le projet ServiceNow associait une forte volumétrie de requêtes, un objectif de performance et une exigence de haute disponibilité. Ces trois sujets guident les choix d’infrastructure : traiter la charge attendue, maintenir un service utilisable et préparer son évolution.
- Charge applicative : dimensionner les ressources en fonction des besoins de l’application.
- Disponibilité : intégrer la continuité de service dans la conception du socle.
- Exploitation : pouvoir suivre le fonctionnement de l’infrastructure et intervenir lorsqu’un comportement se dégrade.
Le travail SRE mené chez OVHcloud
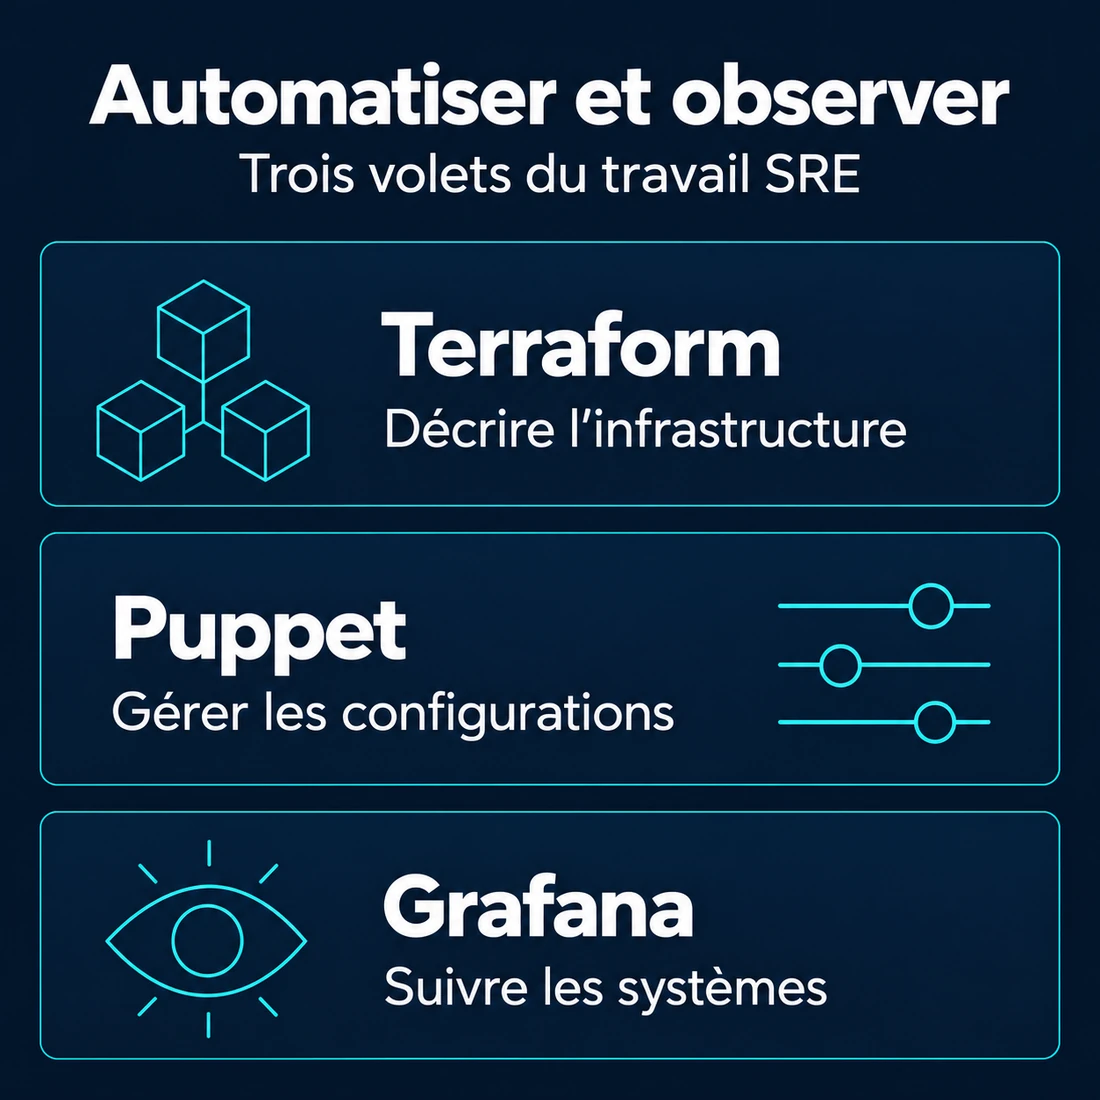
Mon accompagnement chez OVHcloud couvrait aussi l’automatisation de l’infrastructure, la gestion de configuration et l’observabilité. Ces travaux répondent à la même logique : rendre les environnements reproductibles et donner aux équipes les moyens de comprendre leur fonctionnement.
Décrire les ressources dans le code
Développement de modules Terraform pour automatiser la création et la gestion des environnements cloud. Les choix d’infrastructure deviennent une base réutilisable plutôt qu’une succession de manipulations.
Standardiser les configurations
Gestion des serveurs et services avec Puppet, ainsi que travail sur les images systèmes avec Packer et Cloud-init. L’objectif est de retrouver une configuration cohérente au fil des déploiements.
Rendre les systèmes observables
Mise en place d’outils comme OpenSearch, Prometheus et Grafana pour suivre les systèmes, les applications et les performances, et disposer d’éléments utiles à l’analyse des incidents.
Des livrables utilisables au-delà du déploiement
Au sein d’OVHcloud, j’ai développé des modules Terraform, mis en œuvre de la gestion de configuration et construit des tableaux de bord de suivi. L’infrastructure, les configurations et l’observabilité constituent trois volets complémentaires du travail SRE.
Le code permet de rejouer les opérations prises en charge par l’automatisation. La gestion de configuration aide à conserver un socle cohérent. Les tableaux de bord donnent une lecture du fonctionnement des systèmes et des applications, y compris des services Nginx.
Les équipes disposent du code de configuration et des tableaux de bord pour reprendre les changements et suivre les services.
Ce que cette approche apporte aux équipes
Des changements reproductibles
Les ressources et configurations automatisées peuvent être réutilisées lors des évolutions. Le travail technique ne repose plus uniquement sur la répétition de gestes manuels.
Une exploitation plus lisible
Les métriques et tableaux de bord donnent des points de repère pour observer les performances et orienter l’analyse d’un incident.
Un socle préparé à évoluer
La conception et l’automatisation accompagnent les exigences de charge et de disponibilité, plutôt que de traiter l’exploitation après coup.
Sécurité, maintenance et effort dans la durée
Le travail sur les images systèmes et les configurations participe à la standardisation du socle. Il permet de traiter les changements à un niveau réutilisable, puis de les appliquer aux environnements concernés. L’observabilité complète cette démarche : un déploiement doit aussi pouvoir être suivi une fois en service.
Votre application impose de fortes exigences d’exploitation ?
Parlons de la charge, de la disponibilité attendue et des opérations à rendre plus reproductibles sur votre infrastructure.