CLOUD · INCIDENT · SÉCURITÉ
Une réponse incident cloud identité logs réseau efficace commence par une chronologie fiable : qui a agi, quelle API a été appelée, quelle ressource a changé et quel flux réseau a suivi.
📋 Au programme
🧭
Une clé commune
Un identifiant de requête ou de session relie les journaux qui racontent le même événement.
🧾
Préserver avant d’agir
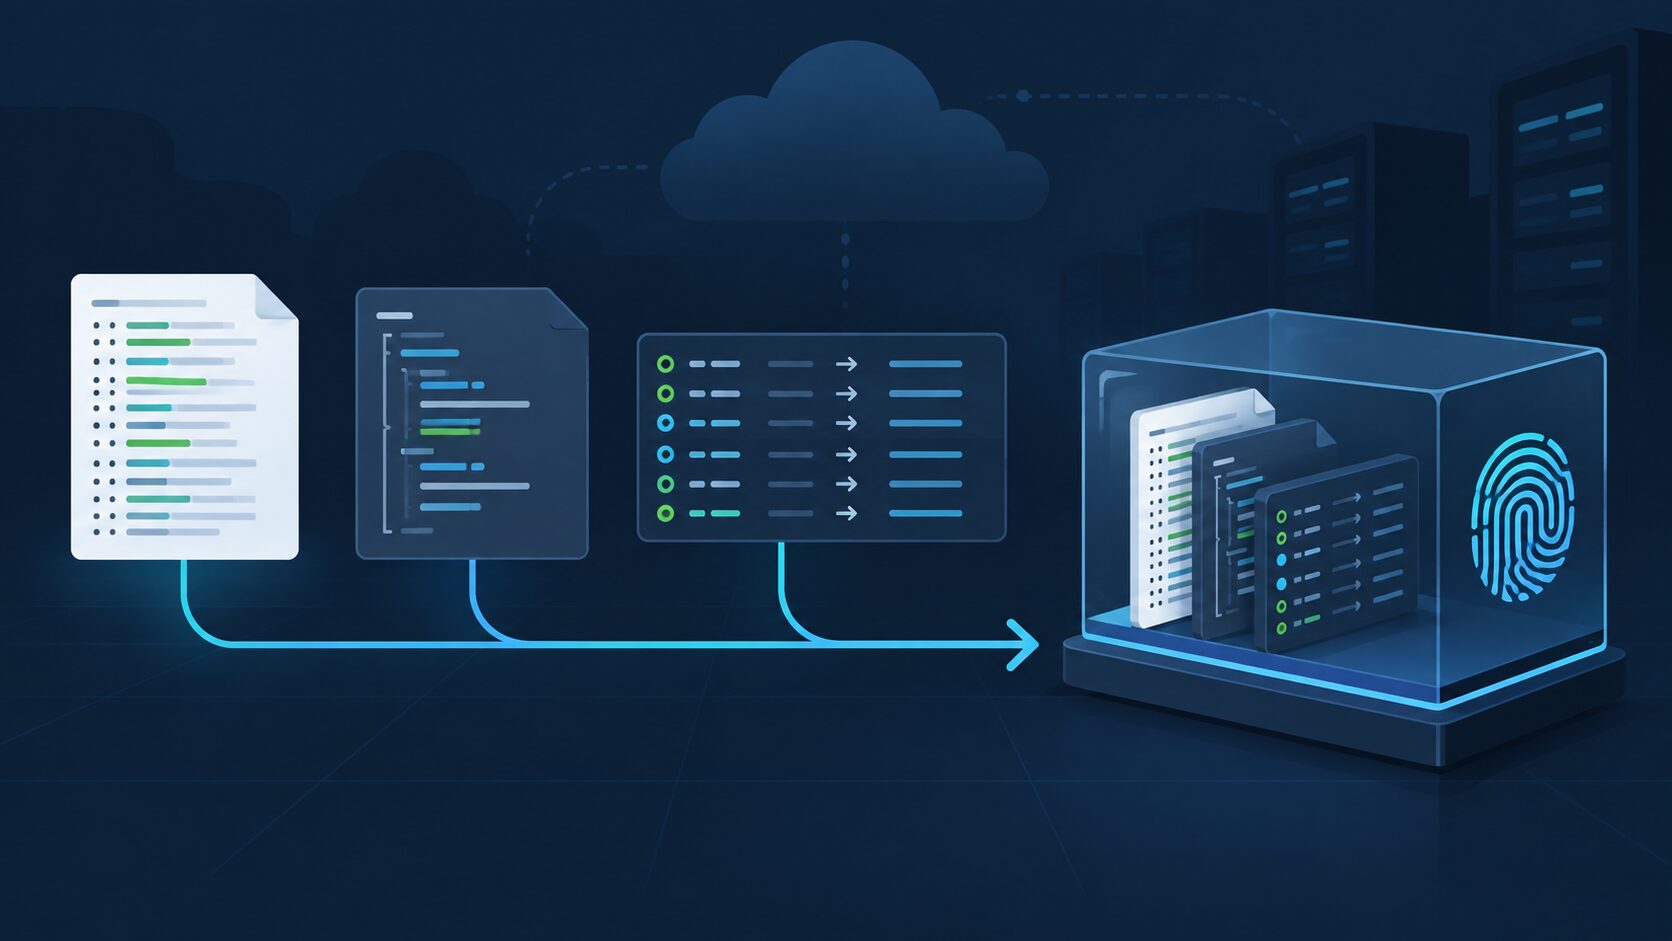
Export horodaté, permissions en lecture seule et empreinte des fichiers avant tout confinement.
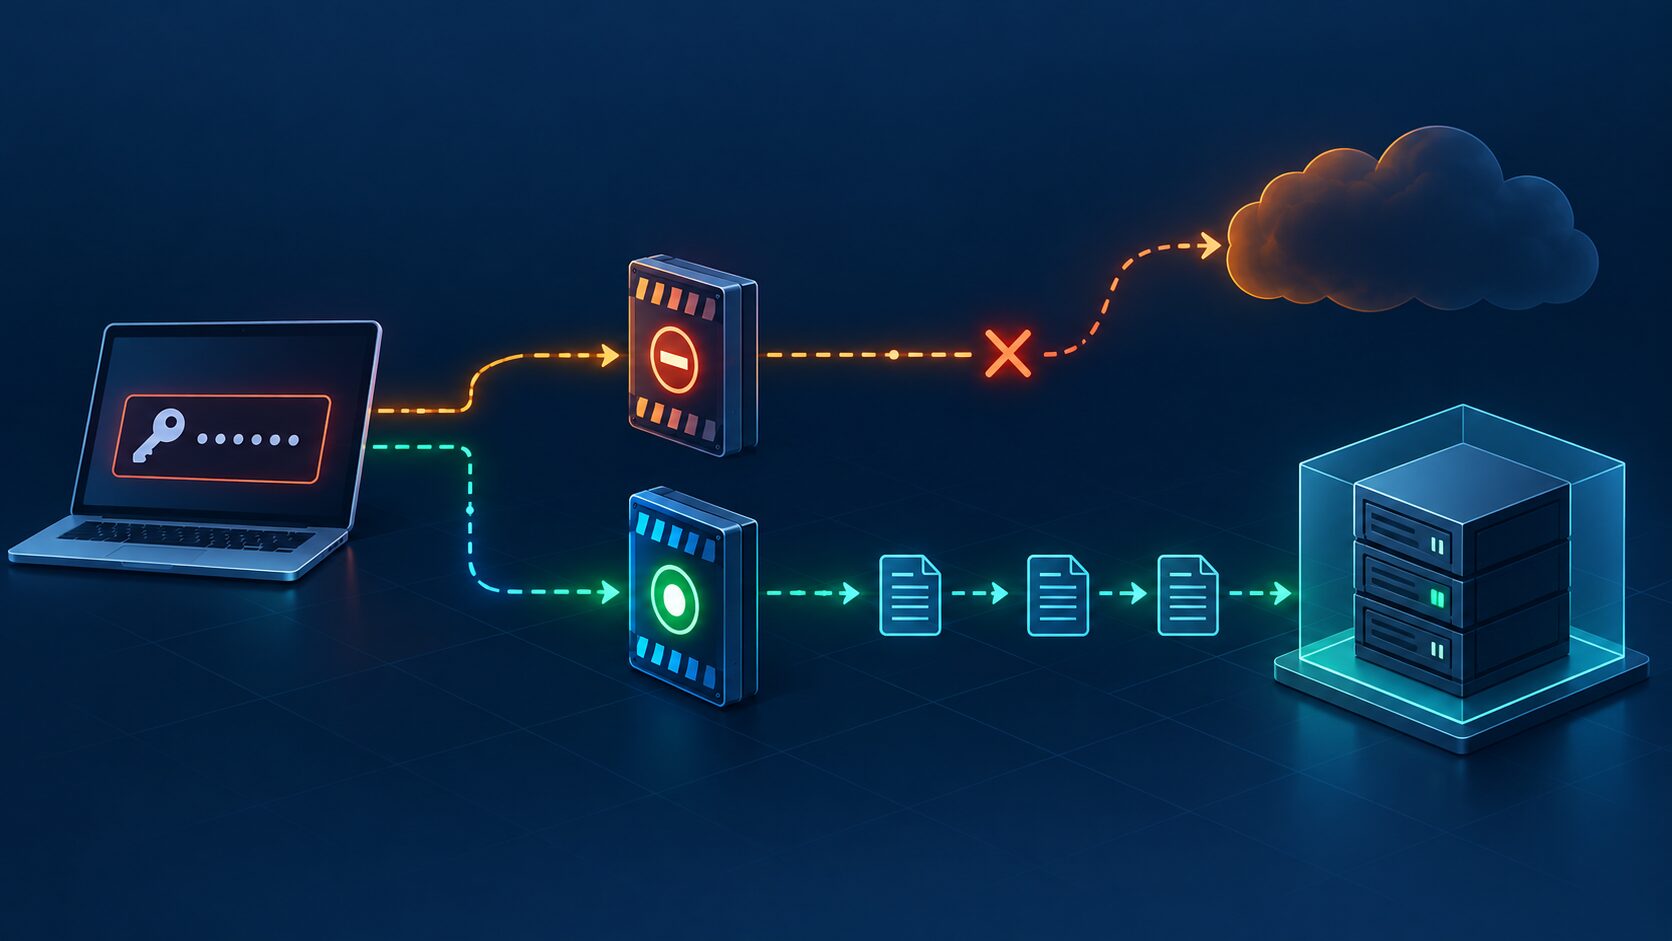
Confinement réversible
Révoquer un token ou isoler un flux doit avoir un propriétaire, une durée et un retour arrière.
Pourquoi la corrélation est le vrai point difficile
Un incident cloud laisse rarement une trace unique. Un compte compromis peut obtenir un token, appeler une API, modifier un rôle, créer une ressource puis exfiltrer des données par un flux sortant. Chaque signal existe parfois dans un service différent, avec son propre format et son propre délai d’ingestion.
Lire les journaux séparément donne donc une histoire incomplète. L’équipe voit un appel API inhabituel, puis une connexion réseau, mais ne sait pas toujours s’il s’agit du même acteur. Elle peut aussi confondre l’utilisateur humain, le rôle assumé, le service qui a exécuté l’action et l’adresse IP d’un relais.
Ne pas supprimer trop vite
La rotation d’un secret est nécessaire, mais elle ne remplace pas l’export des journaux, de la configuration et de la chronologie qui permettront de comprendre l’étendue de la compromission.
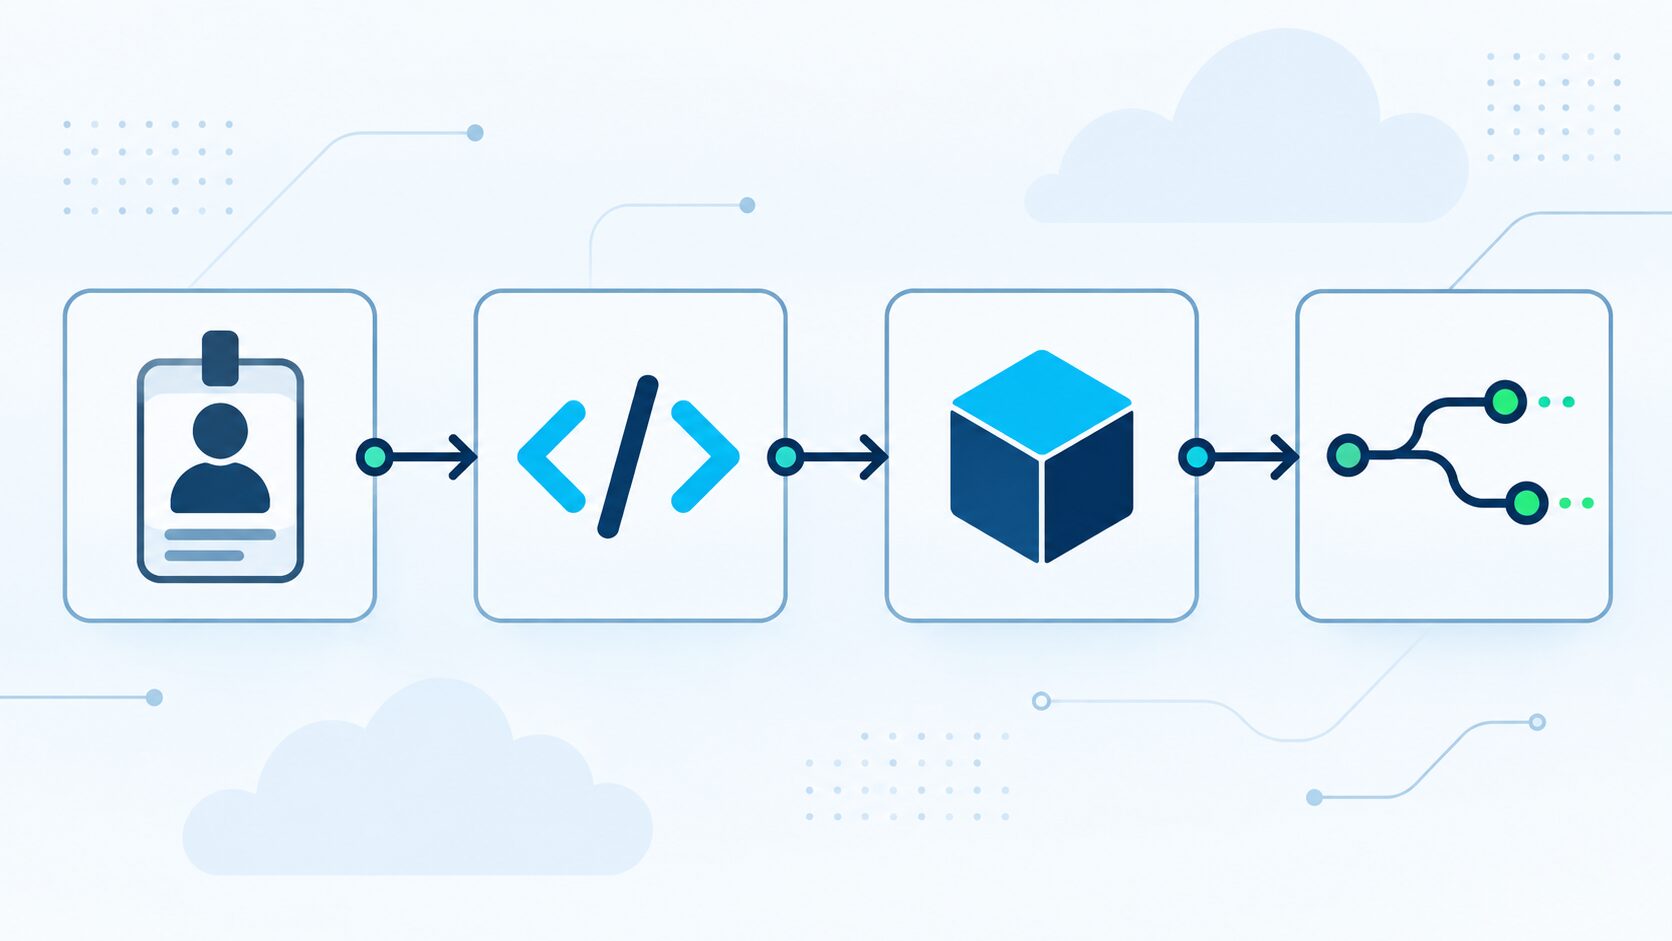
Le modèle identité–API–réseau
Le modèle le plus utile consiste à relier quatre objets : l’identité à l’origine, le mécanisme d’authentification, l’action API et le chemin réseau. L’identité peut être un utilisateur, un rôle, un workload ou un compte de service. Le mécanisme précise comment le droit a été obtenu : clé longue durée, jeton temporaire, fédération ou rôle assumé.
L’appel API décrit l’action concrète : lecture, création, modification, changement de politique ou exfiltration indirecte. Enfin, le réseau apporte le contexte : adresse source, zone, VPC ou sous-réseau, DNS, destination et volume de données. Ensemble, ces éléments permettent de passer d’une alerte abstraite à une hypothèse testable.
Flux à garder en tête
La décision de confinement devient plus fiable lorsque ces quatre vues partagent une horloge et un identifiant de corrélation.
Collecter et normaliser les preuves
Commence par fixer une fenêtre temporelle légèrement plus large que l’alerte initiale. Une marge avant l’événement capture l’accès initial et une marge après l’événement révèle la persistance, les mouvements latéraux ou les tentatives répétées. Note le fuseau, la précision des timestamps et la source de chaque événement.
Conserve les journaux d’identité, les logs d’audit API, les changements IAM, les flux réseau, les logs de proxy, les événements de calcul et les traces applicatives pertinentes. Si un service n’est pas journalisé, écris-le explicitement : une absence de preuve est elle-même un risque à traiter.
Normaliser avant de conclure
Convertis les timestamps en UTC, conserve les identifiants bruts et ajoute des champs dérivés comme actor_id, request_id, resource_id et source_ip.
Mini-lab : construire une chronologie sans toucher à la production
Le mini-lab se fait sur des exports déjà autorisés, dans un répertoire local chiffré ou une VM d’analyse. Il ne demande ni modification IAM ni interrogation active de ressources critiques. L’objectif est de vérifier que les équipes savent relier les événements avant un incident réel.
✅ Pré-requis et périmètre sûr
jq -c 'select(.timestamp >= "2026-09-14T05:00:00Z" and .timestamp <= "2026-09-14T07:00:00Z") | {timestamp,actor_id,request_id,action,resource_id,source_ip}' audit-identity-api.json > identity-api.ndjson
sort -t, -k1,1 identity-api.ndjson > timeline.ndjson
sha256sum audit-identity-api.json audit-network.json
Dans un export réel, adapte le filtre aux noms de champs de ton fournisseur et à la fenêtre de l’incident. Le résultat attendu est une chronologie lisible où un même request_id ou session_id peut être recherché dans plusieurs sources. Si les formats ne partagent aucune clé, rapproche les événements par acteur, ressource, adresse et intervalle temporel, en marquant clairement le niveau de confiance.
Vérifie ensuite trois choses : l’ordre temporel, la cohérence des identités et l’existence d’un événement réseau compatible avec l’action API. Pour le nettoyage, supprime les exports de test selon la politique de rétention et conserve seulement les artefacts approuvés, leur empreinte et la référence de l’incident.
Confiner sans perdre les preuves
Le confinement doit réduire le risque immédiatement tout en gardant la possibilité de reconstruire les faits. Privilégie les actions ciblées : révoquer un token précis, désactiver une clé compromise, réduire temporairement une policy, isoler un workload ou bloquer une destination identifiée. Évite la suppression massive de ressources avant la collecte validée.
Chaque action doit avoir un propriétaire, une heure de début, un motif, une portée et un plan de retour arrière. Si la rotation d’un secret risque de couper un service, prépare un secret de remplacement, teste la bascule et garde l’ancien désactivé mais traçable pendant la période nécessaire. Le rollback n’est pas un retour à l’état compromis : c’est le retour contrôlé à une configuration saine connue.
Point bloquant
Un compte privilégié utilisé pour enquêter peut contaminer la chronologie. Utilise des accès nominatifs, temporaires et journalisés, séparés du compte suspect.
Checklist opérationnelle
✅ Avant, pendant et après l’incident
✓ Identité humaine, rôle, workload et source d’authentification sont distingués.
✓ Les appels API, changements IAM et ressources ciblées sont exportés.
✓ Les flux entrants et sortants pertinents sont conservés.
✓ Les artefacts sont hashés et stockés en lecture seule.
✓ Chaque action de confinement a un propriétaire et un rollback.
✓ Les permissions inutilisées sont réduites après validation métier.
✓ Un test de restauration et une revue post-incident sont planifiés.
Erreurs fréquentes
⏱ Se fier uniquement à l’horodatage
Des sources désynchronisées peuvent faire croire à deux incidents distincts. Conserve l’heure brute et la correction appliquée.
🔑 Confondre utilisateur et rôle
L’utilisateur qui assume un rôle n’est pas la seule identité à suivre : le rôle, la session et le workload doivent rester liés.
🧹 Nettoyer avant d’exporter
Supprimer une ressource ou purger un log peut empêcher de mesurer l’impact et de répondre aux questions du client.
FAQ
Après le confinement : mesurer et apprendre
Le confinement ne termine pas l’incident. Il ouvre une phase de validation où l’équipe vérifie que l’accès réellement utilisé a disparu, que les services critiques fonctionnent encore et qu’aucune nouvelle identité n’a été créée pour maintenir la persistance. Cette vérification doit être menée sur une période adaptée à la durée de vie des tokens, aux cycles de rotation et au niveau de sensibilité des données.
Compare les événements avant et après la mesure de confinement. Une baisse des appels suspects est utile, mais elle ne suffit pas : l’attaquant peut changer d’identité, de région, de rôle ou de canal de sortie. Cherche aussi les échecs d’authentification, les nouvelles policies, les règles réseau modifiées, les jobs planifiés et les accès à des ressources rarement utilisées.
Validation post-confinement
Fais valider par le propriétaire du service que les flux légitimes sont revenus à la normale et conserve la preuve de cette validation avec la chronologie.
Rendre le runbook réutilisable
Un bon retour d’expérience transforme les constats en contrôles automatisables. Ajoute les champs manquants au schéma de logs, documente les correspondances entre identités et workloads, et fixe un délai maximal d’ingestion. Si l’équipe a dû chercher manuellement une information, indique où elle devrait apparaître la prochaine fois.
Le runbook doit aussi préciser les seuils d’escalade. Une lecture inhabituelle n’a pas la même gravité qu’une modification de policy suivie d’une exfiltration. Définis les critères qui déclenchent l’astreinte, l’information du client, l’appel au fournisseur cloud ou la conservation juridique renforcée des éléments.
Enfin, répète l’exercice sur un scénario sans impact : token de test, ressource non sensible, flux contrôlé et fenêtre courte. Le but est de vérifier les permissions de lecture, la disponibilité des exports, les délais de décision et la qualité du rollback. Une équipe qui s’entraîne réduit le temps perdu au moment où chaque minute compte.
Conclusion
Une réponse à incident cloud fiable ne consiste pas à accumuler des logs. Elle consiste à relier les bonnes identités aux bonnes actions, puis à vérifier qu’un flux réseau confirme ou infirme l’hypothèse. Cette méthode réduit les décisions prises à l’aveugle et accélère le confinement.
Besoin de préparer votre réponse à incident cloud ?
Je peux vous aider à cartographier les journaux, formaliser le runbook et tester un confinement réversible.