CI/CD · SÉCURITÉ · RÉSEAU
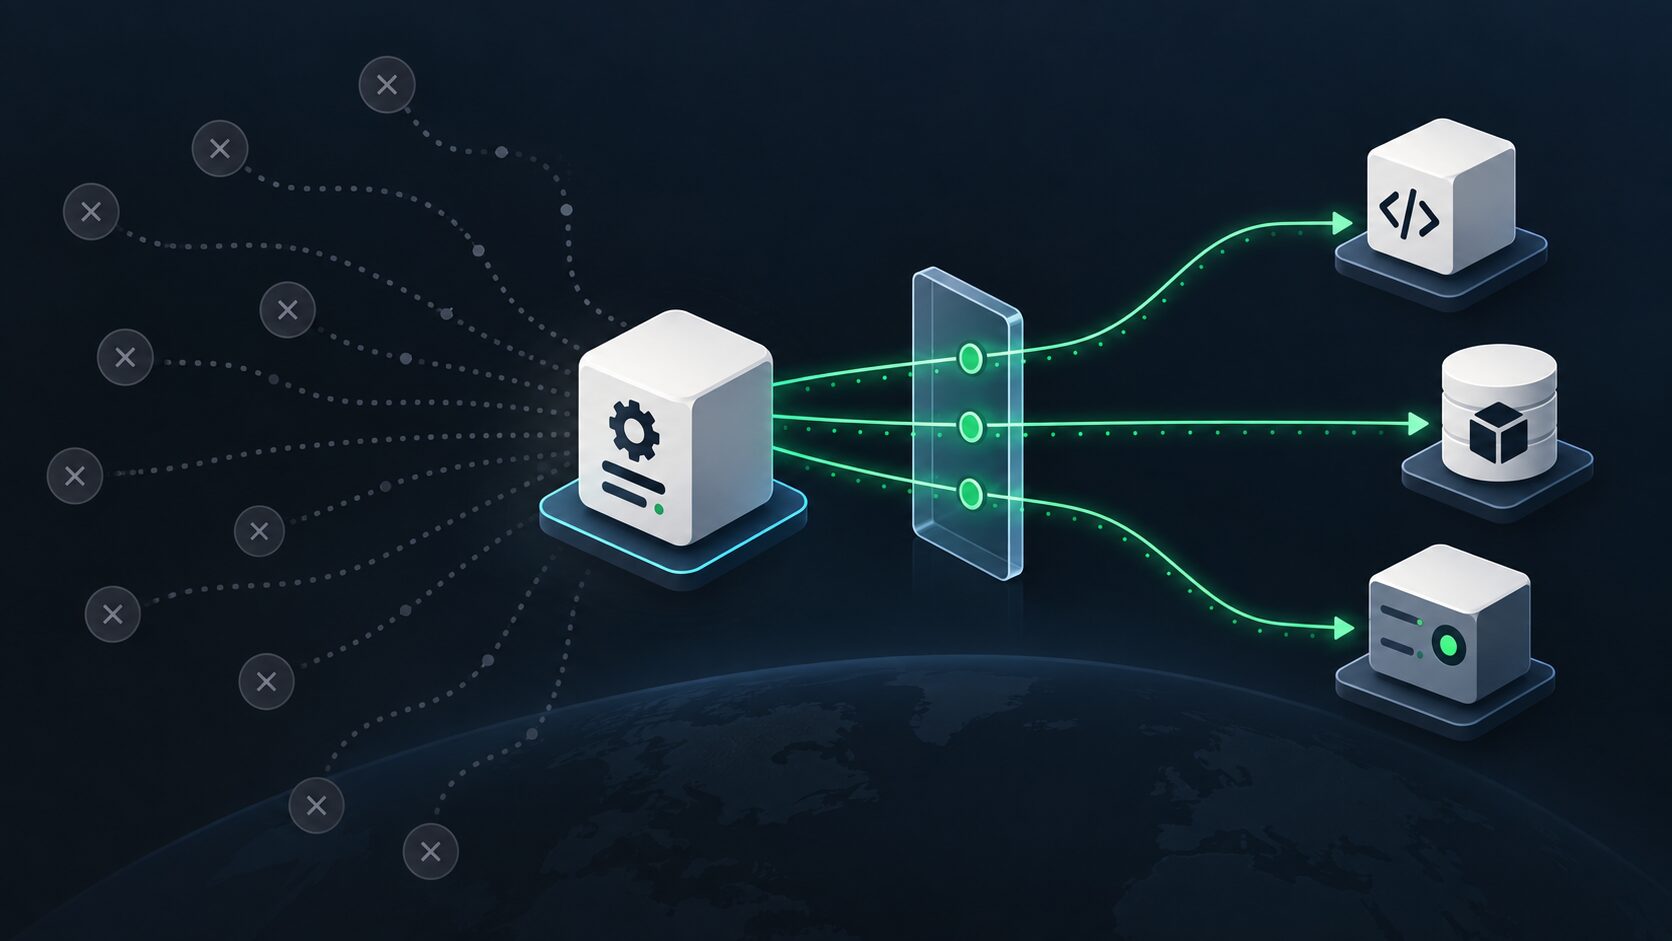
Restreindre les sorties réseau des runners CI/CD réduit l’exfiltration et le rayon d’impact d’un pipeline compromis. La méthode consiste à observer les flux réels, construire une allowlist progressive et prévoir une exception réversible pour ne pas casser les déploiements.
🧱
Deny par défaut
Un runner ne doit joindre que les destinations nécessaires au job.
🔎
Observer avant de bloquer
Les logs DNS, proxy et firewall révèlent les dépendances implicites.
↩️
Rollback prévu
Chaque règle doit pouvoir être désactivée sans reconstruire le runner.
📋 Au programme
Pourquoi restreindre les sorties réseau d’un runner CI/CD
Un runner exécute du code qui change souvent : branches de pull request, dépendances, scripts de build et outils d’automatisation. Si ce code est compromis, la machine peut tenter d’exfiltrer des secrets ou de contacter une infrastructure hostile.
Le contrôle des flux sortants complète les permissions GitHub Actions, les credentials courts et l’isolation des runners. Il ne remplace aucune de ces protections : il limite surtout ce qu’un job peut faire après avoir obtenu une exécution.
Le bon objectif
Il ne s’agit pas de rendre le runner hors ligne. Il s’agit de rendre ses connexions explicites, observables et proportionnées au job exécuté.
Le modèle d’accès : observer, allowlister, contrôler
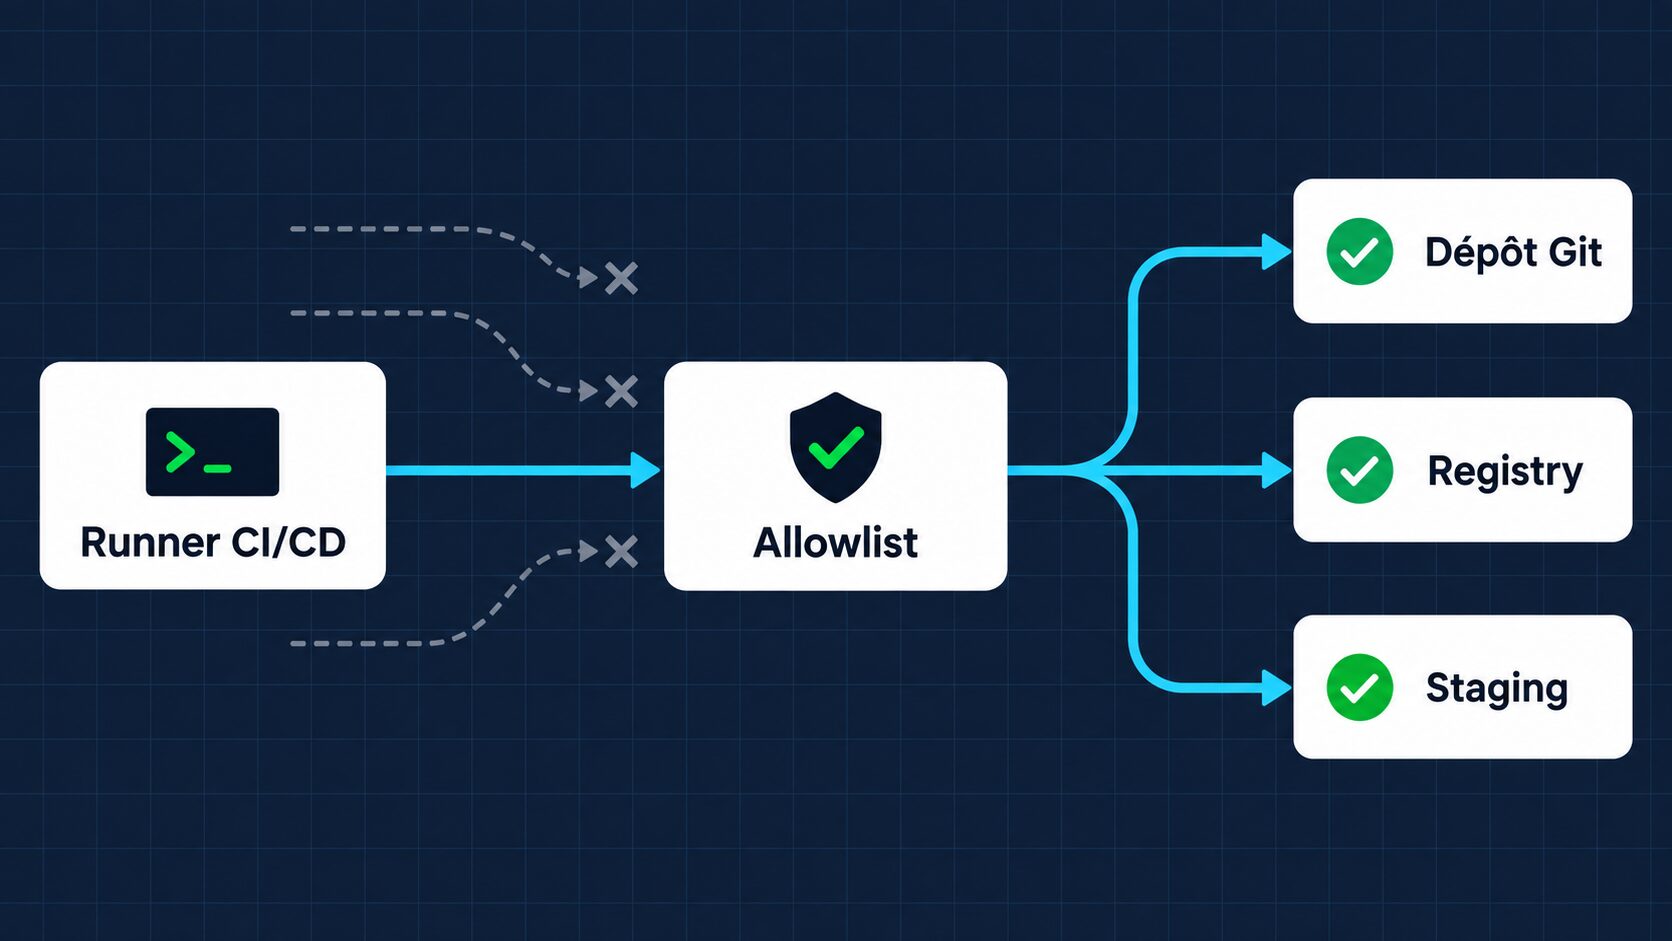
Flux à garder en tête
Le point de contrôle peut se situer sur le réseau du runner, dans un proxy egress ou dans un firewall externe. L’important est de corréler la décision avec le dépôt, le workflow et l’environnement.
Commence par un périmètre de confiance : runners dédiés aux branches protégées, jobs de déploiement séparés des jobs de pull request et secrets injectés uniquement au dernier moment. Un runner qui compile du code non approuvé ne devrait pas partager le même accès réseau qu’un runner de production.
Inventorier les flux avant d’ajouter des règles
Les dépendances réseau sont rarement toutes documentées. Un build peut contacter le registre de conteneurs, le dépôt de paquets, une autorité de certificats, un fournisseur cloud ou un service de scan. Une allowlist écrite sans observation casse souvent une étape légitime.
# Exemple d’observation locale sur un runner Linux
sudo ss -tpn
sudo journalctl -u docker --since "15 minutes ago"
sudo tcpdump -ni any 'tcp and (port 80 or port 443)' -c 100
getent hosts registry.example.com
Dans un environnement réel, préfère les logs d’un proxy ou d’un firewall centralisé. Enregistre au minimum l’identité du runner, le workflow, la destination, le port, l’action autorisée ou bloquée et une durée de rétention adaptée à l’investigation.
Attention aux domaines trop larges
Autoriser tout un CDN ou une plage cloud parce qu’un job utilise une URL ponctuelle revient souvent à recréer une sortie ouverte. Préfère des destinations stables, documentées et vérifiables.
Mini-lab : tester une allowlist sans risque
Le test ci-dessous utilise un conteneur jetable. Il ne modifie pas un runner de production et sert à valider le principe : une destination connue passe, une destination non déclarée est bloquée ou journalisée.
✅ Pré-requis et périmètre
registry.example.comdocker network create --internal ci-egress-lab
docker run --rm --network ci-egress-lab alpine:3.20 sh -c \
'apk add --no-cache curl && curl -I --max-time 5 https://registry.example.com'
# Résultat attendu : la résolution ou la connexion échoue tant qu’aucune
# passerelle egress de test n’autorise explicitement la destination.
docker network rm ci-egress-labSur un runner réellement utilisé, remplace l’expérimentation par un mode observation. Mesure le taux de jobs réussis, les destinations bloquées, la durée du build et les exceptions demandées. Le rollback consiste à désactiver la politique d’enforcement, pas à supprimer les logs ni les règles versionnées.
Déployer progressivement sans casser les déploiements
La première étape de production est une politique en mode audit. Elle produit des événements mais ne bloque rien. Après quelques cycles représentatifs, classe les destinations : indispensables, temporaires, liées à un outil à remplacer ou suspectes.
Ensuite, applique l’enforcement sur un seul groupe de runners. Les workflows de déploiement doivent rester séparés des workflows de contribution. Une exception temporaire doit avoir un propriétaire, une justification, une date d’expiration et une alerte si elle est encore active.
Garde-fou opérationnel
Versionne l’allowlist, fais-la relire comme du code et teste-la sur un workflow de référence. Une règle réseau non testée est une dette d’exploitation.
Checklist de mise en œuvre
✅ Avant l’enforcement
Erreurs courantes
Autoriser 0.0.0.0/0 pour “dépanner”
Cette exception masque la dépendance réelle et devient souvent permanente. Journalise le flux manquant puis corrige la règle ciblée.
Mélanger build et déploiement
Les deux phases n’ont pas les mêmes destinations ni le même niveau de confiance. Des runners distincts simplifient les politiques.
Bloquer sans prévoir les certificats et DNS
Une allowlist réseau doit tenir compte de la résolution DNS, des chaînes TLS et des endpoints de téléchargement réellement utilisés.
Faire vivre l’allowlist dans le temps
Une politique egress dérive dès que les équipes ajoutent un nouvel outil de build, changent de registre ou migrent un fournisseur cloud. L’allowlist doit donc être gérée comme un composant de la chaîne de livraison, avec une revue régulière et un historique compréhensible.
Chaque entrée devrait répondre à quatre questions : quel workflow l’utilise, quelle opération nécessite cette destination, qui en est responsable et quand la règle sera réévaluée ? Cette discipline évite les domaines orphelins qui restent autorisés après la suppression d’un outil.
Dans une PME SaaS, un fichier versionné peut suffire au départ. Le dépôt contient les règles par environnement, les exceptions temporaires et le résultat des tests. Une modification passe par une pull request distincte, relue par une personne qui connaît à la fois le réseau et le pipeline.
# Exemple de contrat d’allowlist lisible
environment: staging
runner_group: trusted-deploy
destinations:
  - host: registry.example.com
    ports: [443]
    reason: pull des images applicatives
    owner: equipe-platform
    expires: 2026-12-31
  - host: api.cloud.example
    ports: [443]
    reason: déploiement Terraform
    owner: equipe-infra
    expires: 2026-12-31
Le champ d’expiration est essentiel. Une exception sans date ressemble rapidement à une règle permanente, même si elle avait été créée pour dépanner une seule release. Une alerte hebdomadaire sur les expirations permet de traiter le sujet pendant les heures ouvrées.
Mesurer la sécurité sans dégrader la livraison
Le succès ne se mesure pas uniquement au nombre de connexions bloquées. Une politique trop stricte peut provoquer des contournements, des désactivations manuelles ou des délais de livraison qui poussent les équipes à chercher une solution moins sûre.
Surveille plutôt quelques indicateurs simples : taux de jobs réussis, temps médian du build, nombre d’exceptions actives, destinations inconnues par semaine et délai de traitement d’une demande d’accès. Compare ces mesures avant et après l’enforcement sur le même groupe de workflows.
Un blocage doit produire un événement actionnable. Le message doit identifier le dépôt, le workflow, le runner, la destination et la règle manquante. « Connexion refusée » ne suffit pas : l’équipe doit pouvoir décider rapidement si elle corrige le job, ajoute une destination justifiée ou traite une tentative suspecte.
Signal de compromission possible
Une destination inconnue appelée uniquement depuis une branche non protégée doit être traitée comme un événement de sécurité, pas comme une simple demande de déblocage.
Enfin, documente le chemin d’exception avant le jour où il sera nécessaire. Le demandeur fournit le workflow concerné, la destination exacte, la durée prévue et le résultat attendu. L’équipe plateforme peut alors accorder une règle limitée, vérifier son usage dans les logs, puis la retirer. Ce mécanisme protège la continuité métier tout en empêchant le dépannage de devenir une ouverture durable. Il faut également tester la procédure avec une personne qui n’a pas écrit la règle : si elle ne comprend pas le blocage, l’alerte et le retour arrière, le runbook est trop implicite. Cette relecture révèle souvent les dépendances oubliées et les responsabilités ambiguës.
Conclusion
La restriction des sorties réseau des runners CI/CD devient efficace quand elle est traitée comme une capacité d’exploitation : inventaire, règles versionnées, séparation des niveaux de confiance, alertes et rollback. Cette approche protège les déploiements sans transformer chaque incident de build en arrêt de livraison.
FAQ
Besoin de sécuriser votre chaîne CI/CD ?
Linux-Man peut vous aider à cartographier les flux, isoler les runners et construire une politique progressive adaptée à votre production.